Am 11. August 2026 hat NVIDIA mit Nemotron 3.5 Lightning sein erstes offenes Modell der neuen Reihe veröffentlicht: 31,6 Mrd. Parameter, ausdrücklich für Agenten-Aufgaben beworben, und laut Datenblatt auf Augenhöhe mit Modellen der vierfachen Größe. Drei Tage später lief es bei uns auf einer NVIDIA DGX Spark im Vergleichstest gegen unser Produktivmodell. So schnell geht das, wenn die Testmaschine im Haus steht.
Genau darum geht es in dieser Reihe: Wir erzählen keine Datenblätter nach, sondern messen neue Modelle mit echten Aufgaben auf echter Hardware – bevor sie irgendwo produktiv laufen.
Warum wir überhaupt selbst testen
Bestenlisten sagen Dir, wie ein Modell in einem Labor abschneidet. Sie sagen Dir nicht, wie es sich bei Deinen Daten, Deinen Werkzeugen und Deinen Rückfragen verhält. Ein Modell, das in der Rangliste glänzt, kann im Betrieb Zahlen erfinden – und das merkst Du erst, wenn Du es vor dem Einsatz prüfst.
Deshalb betreiben wir eine eigene DGX Spark als Testmaschine und ein Vergleichswerkzeug, das mit unseren echten Fällen arbeitet: Anfragen aus dem Vertrieb, technische Dokumente, Werkzeugaufrufe gegen unsere Systeme.
Der Aufbau des Härtetests
Wir haben zwei Modelle auf derselben Maschine gegeneinander laufen lassen: das neue Nemotron 3.5 Lightning und unser bewährtes Produktivmodell. Getestet wurde in drei Disziplinen:
- Agentischer Werkzeugtest: 87 Fälle in drei Runden mit echten ERP-Werkzeugen – wählt das Modell das richtige Werkzeug und wie schnell?
- Chat-Antwortzeit: Wie lange dauert eine vollständige Antwort im normalen Dialog?
- Faktenprüfung: 16 Chat-Fälle, in denen wir gezielt nach Werten fragen, die in den Quelldokumenten stehen – oder eben nicht.
Die Ergebnisse im Detail
Werkzeugwahl: knapp, aber mit Preis
Unser Produktivmodell erreichte 98,9 % korrekte Werkzeugwahl, Nemotron 3.5 Lightning 95,6 %. Der Unterschied klingt klein, kostet im Betrieb aber Zeit: 7,4 Sekunden pro Aufruf gegenüber 3,0 Sekunden beim bewährten Modell. In einer Kette von Werkzeugaufrufen summiert sich das.
Antwortzeit: von den beworbenen Token-Raten kam nichts an
Im Chat lag unser Modell bei 0,37 Sekunden für eine vollständige Antwort, Nemotron bei 0,53 bis 0,89 Sekunden. Die beworbenen rund 670 Token pro Sekunde haben wir auf dieser Hardware nicht gesehen.
Der entscheidende Punkt: erfundene Fakten
Im Schnellmodus, also ohne eingeschaltetes Reasoning, hat Nemotron in 7 von 16 Chat-Fällen Fakten erfunden. Darunter ein Druckergewicht von „150 kg“, das in keinem Dokument stand, und komplette Verkaufszahlen samt Artikelnummern, die es nicht gibt. Unser Modell: 0 von 16.
Mit eingeschaltetem Reasoning verschwinden die Erfindungen – dann ist das Modell aber rund 2,5-mal langsamer und liegt in der Werkzeugwahl weiterhin hinter unserem Produktivmodell.
Wo Nemotron gewinnt
Ein Feld hat das neue Modell für sich entschieden: die Textextraktion aus PDFs, mit 88,9 % gegenüber 85,9 %. Wer ausschließlich PDFs in Text verwandeln will, hat hier einen echten Kandidaten.
Was das für Deinen Einsatz bedeutet
- Ein Modell ist kein Alleskönner: Als reiner PDF-Text-Spezialist wäre Nemotron die bessere Wahl – für unsere Agenten- und Chat-Aufgaben ist das bewährte Modell vorne.
- Reasoning kostet Zeit: Erfindungen verschwinden, wenn Du Reasoning einschaltest, aber die Antworten werden deutlich langsamer. Das musst Du in Deine Anforderungen einrechnen.
- Messen schlägt Nachlesen: Die Lücke zwischen Datenblatt und Betrieb ist real. Nur ein Test mit Deinen Fällen zeigt, welches Modell zu Dir passt.
Das Ergebnis heißt nicht, dass Nemotron 3.5 Lightning schlecht ist. Es heißt: Für unsere Aufgaben auf dieser Hardware ist unser bewährtes Modell die bessere Wahl. Deine Antwort kann anders ausfallen.
Die DGX Spark als Testplattform
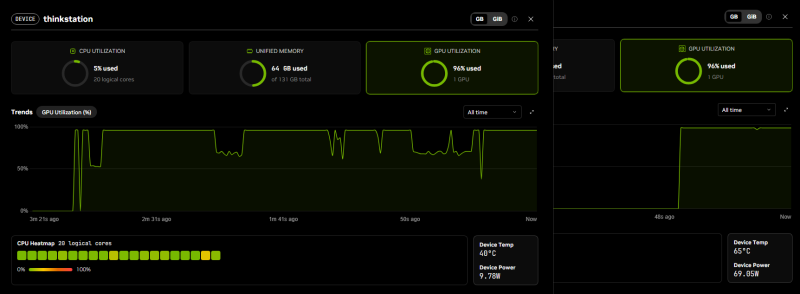
Möglich wird dieser schnelle Test, weil die Testmaschine im Haus steht. Die Lenovo ThinkStation PGX GB10 ist eine kompakte Workstation mit NVIDIA GB10 Grace Blackwell Superchip, 128 GB Arbeitsspeicher und 1 TB NVMe-SSD, vorinstalliert mit NVIDIA DGX OS. Reicht die Leistung nicht, lassen sich zwei Einheiten per Kabel zusammenschließen.
Genau so eine Maschine nutzen wir, um neue Modelle binnen Tagen nach Release mit unseren echten Fällen zu prüfen – und um zu sehen, ob sie zu Deinen passen. Wie wir lokale KI im Alltag betreiben, haben wir in einem eigenen Erfahrungsbericht zusammengefasst. Und wenn Du wissen willst, wie wir bei der Modellwahl vorgehen, lies unseren Beitrag KI-Modellwahl: Warum wir testen statt raten.
Wir testen auch mit Deinen Fällen, bevor Du investierst – Termin über /contact-us/, gern im Showroom in Recklinghausen.
Aktuelles rund um lokale KI
 05Okt
Nemotron 3.5 Lightning im Härtetest: Warum das bewährte Modell gewinnt
NVIDIA veröffentlicht Nemotron 3.5 Lightning, drei Tage später läuft es bei uns auf einer DGX Spark gegen unser Produktivmodell. Das Ergebnis: Im Schnellmodus erfindet das neue Modell in 7 von 16 Chat-Fällen Fakten – unser Modell in keinem. Ein Praxisbericht über Messen statt Nachbeten.
weiterlesen 02Okt
KI-Server inklusive: Was der SideKick-Server in TeamDavid für Dich bedeutet
Mit dem Rollout steckt der datenschutzkonforme KI-Server SideKick direkt in jeder TeamDavid-Installation mit sitecare. Wir zeigen Dir, was das im Alltag bringt, wie Du ihn aktivierst und warum Deine Daten dabei in Europa bleiben.
weiterlesen 01Okt
KI im eigenen Haus: Warum feste Kosten langfristig günstiger sind
Lokale KI auf eigener Hardware macht Deine Kosten planbar: keine Token-Preise, kein Speicherpreis-Risiko, volle Kontrolle. So rechnest Du es durch.
weiterlesen 01Okt
Zehnter Windows-Zero-Day: Was das für Deine IT-Sicherheit bedeutet
Ein anonymer Sicherheitsforscher veröffentlicht immer neue Windows-Lücken – teils live ausgenutzt. Wir ordnen ein, was das für Unternehmen heißt und wann ein Systemwechsel sinnvoll ist.
weiterlesen 16Sep
Tobit TeamDavid bringt SideKick Server mit: KI-Funktionen ohne Extra-Invest
TeamDavid mit sitecare bekommt ab dem nächsten Rollout einen eigenen SideKick Server – inklusive Agentic Workspace, Agentic Analysis und Agentic Service. Wir zeigen Dir, was das für Deine Zusammenarbeit und Deinen Kundenservice bedeutet.
weiterlesen