Jede Woche kündigt ein Hersteller das nächste „bahnbrechende“ KI-Modell an. Für Dein Unternehmen zählt aber nur eine Frage: Löst es Deine Aufgabe zuverlässig – auf Deiner Hardware, mit Deinen Daten, im laufenden Betrieb? Diese Frage beantworten weder Datenblätter noch Bestenlisten. Deshalb testen wir bei Karley KI-Modelle nicht nach Gefühl. Wir lassen sie gegen echte Fälle antreten – mit denselben Testdaten, denselben Messkriterien und einer klaren Auswertung in Zahlen.
Warum Datenblätter nicht weiterhelfen
Hersteller vergleichen ihre Modelle gern mit öffentlichen Benchmarks. Die zeigen, wie gut ein Modell bei Standardaufgaben abschneidet. Aber Dein Alltag sieht anders aus: Du verarbeitest Rechnungen mit unterschiedlichen Formaten, suchst Abweichungen in Bestellungen oder lässt Texte aus schlecht gescannten Belegen extrahieren. Ob ein Modell das kann, steht in keinem Datenblatt.
Für die Praxis zählen vor allem diese Punkte:
- Antwortqualität bei typischen Büroaufgaben – nicht bei Kunstprojekten.
- Stabilität unter Last: Was passiert, wenn mehrere Mitarbeiter gleichzeitig Anfragen stellen?
- Latenz pro Antwort: Wie schnell liefert das Modell ein brauchbares Ergebnis?
- Robustheit bei schlechten Vorlagen: Schiefe Scans, handschriftliche Notizen, PDF-Spaltensalat?
Erst wenn ein Modell diese Punkte erfüllt, ist es für den Produktiveinsatz geeignet. Alles andere bleibt Spielerei.
Unsere Methode: Modelle gegen echte Fälle
Wir haben ein eigenes Vergleichswerkzeug entwickelt, das Kandidaten nach einem festen Schema testet. So läuft jedes Modell unter denselben Bedingungen – und die Ergebnisse sind direkt vergleichbar. Das ist keine Meinung, sondern Messung.
Was wir konkret prüfen
- Rechnungsprüfung: Findet das Modell Abweichungen zwischen Rechnung und Bestellung?
- Lieferantenabweichungen erkennen: Erkennt es falsche Preise, Mengen oder Konditionen?
- Bestellungen aus E-Mails und PDF-Anhängen extrahieren: Zieht es die relevanten Felder zuverlässig heraus?
- Übersetzungen und Textgenerierung: Liefert es fachlich passende und sprachlich korrekte Texte?
- OCR und Textextraktion: Wie gut liest es schlecht gescannte Belege?
- Chat-Fälle gegen die Wissensdatenbank: Gibt es präzise Antworten – und erfindet es keine Inhalte?
- Agentischer Test: Ruft das Modell die richtigen Werkzeuge auf, hält es mehrstufige Abläufe durch und sagt es ehrlich „das kann ich nicht“?
Unsere Testdaten sind realistisch, aber anonymisiert. Es kommt nicht darauf an, welche Marke auf dem Papier steht, sondern wie sich das Modell in Deiner Aufgabenwelt verhält.
Ein Beispiel: Das neue Modell war nicht besser
Im August 2026 haben wir einen viel beworbenen neuen Kandidaten gegen unser produktives Modell antreten lassen. Das Ergebnis war eindeutig: Der Neue ist nicht nur langsamer, sondern fällt unter realistischen Bedingungen regelrecht ab. Wichtig war uns die Messung, nicht der Hype.
- Es war rund sechsmal langsamer pro Token als das bisherige Modell.
- Bei mehreren gleichzeitigen Anfragen brach die Antwortgeschwindigkeit fast vollständig ein.
- In etwa einem Viertel der Chat-Fälle lieferte es leere Antworten.
- Im Werkzeugtest erfand es Funktionsnamen, statt auf vorhandene Tools zuzugreifen.
Unser produktives Modell löste dagegen alle 18 agentischen Testfälle korrekt. Die Lehre aus diesem Test: Größe und Neuheit sind keine Qualitätsmerkmale. Ein Modell, das unter Last zusammenbricht, fällt im Echtbetrieb erst auf, wenn es zu spät ist – es sei denn, Du misst vorher.
So läuft ein KI-Modelltest bei Dir ab
Du musst kein KI-Experte sein, um von unserem Test zu profitieren. Wir übernehmen die Auswertung und bereiten alles so auf, dass Du eine klare Entscheidung treffen kannst.
- Wir besprechen Deine Aufgabenstellung und definieren gemeinsame Testfälle.
- Wir hinterlegen für alle Kandidaten dieselben Testdaten.
- Jedes Modell läuft unter vergleichbaren Bedingungen – gleiche Hardware, gleiche Anfragen.
- Wir dokumentieren Antwortzeit, Fehlerquote und besondere Vorkommnisse.
- Du bekommst eine Empfehlung mit gemessenen Zahlen statt einer Werbebroschüre.
Auf Wunsch arbeiten wir direkt in Deiner Umgebung. Wer sensible Daten nicht in die Cloud geben möchte, findet in unserem Beitrag KI-Datenanalyse lokal statt Cloud die passenden Rahmenbedingungen. Und wie Modelle auf der eigenen Workstation produktiv laufen, zeigt der Beitrag On-Premise-KI für den Mittelstand.
Was Du am Ende bekommst
Unser Ziel ist kein Verkaufsgespräch, sondern eine belastbare Grundlage. Nach dem Test weißt Du, ob sich Dein KI-Projekt lohnt, bevor Du investierst. Du erhältst eine Empfehlung mit konkreten Zahlen: welches Modell, welche Hardware, welche Antwortzeiten, welche Fehlerquote. Damit kannst Du das Risiko minimieren und Dein Budget gezielt einsetzen.
Und wenn Du eine leistungsstarke Basis für den lokalen Betrieb suchst, zeigen wir Dir gern passende Workstations wie die Lenovo ThinkStation GB10. Aber erst, wenn die Messergebnisse klar sind. Mehr über unsere KI-Angebote und offene Fragerunden findest Du auf unserer KI-Seite.
Testtermin im Showroom – oder direkt bei Dir
Überzeuge Dich selbst: Bring Deine Unterlagen mit, wir führen den Test gemeinsam durch und Du siehst live, wie sich die Modelle unterscheiden. Geht es Dir nur um eine erste Einschätzung, beraten wir Dich auch unverbindlich im Showroom oder remote. Schreib uns einfach über unser Kontaktformular – wir melden uns zeitnah und vereinbaren einen Termin, der zu Dir passt.
Aktuelles rund um KI-Modelle
 09Nov
Lokale KI-Modelle im Vergleich: Warum wir bei Qwen3.6 bleiben
Wir haben unser Produktionsmodell Qwen3.6 mit einem Community-Destillat verglichen: Tempo auf dem DGX Spark und fünf echte Kundenfragen. Das Destillat ist langsamer und erfindet mehr.
weiterlesen 31Okt
Team david Rollout 537: Mehrere Monitore, Schriften und Stabilität im Client
Das neue Rollout 537 für Team david bringt Verbesserungen für mehrere Monitore mit unterschiedlicher Skalierung, zuletzt verwendete Schriften im Editor und eine Reihe von Bugfixes. Wir fassen zusammen, was sich für Dich ändert.
weiterlesen
 26Okt
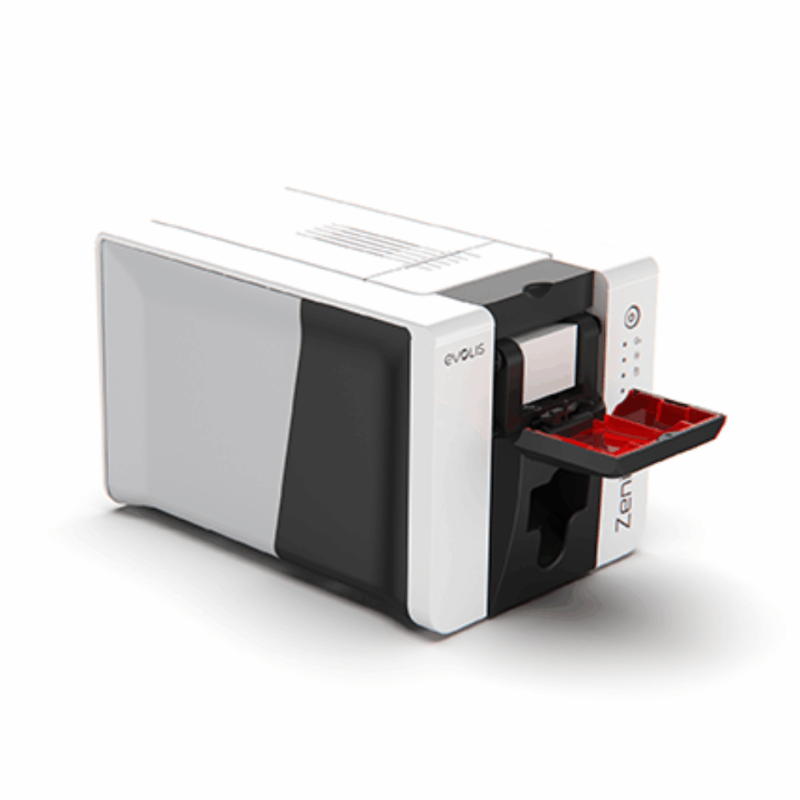
Evolis Zenius 2: Ausweise und Karten selbst drucken
Der Evolis Zenius 2 druckt Mitarbeiterausweise, Zutrittskarten und Mitgliedskarten direkt im Betrieb. Bis zu 180 Farbkarten pro Stunde, 50 Karten im Einzug, Rewrite für wiederbeschreibbare Karten.
weiterlesen 20Okt
Zebra DS8208-R und DS8288-R: Barcode und RFID in einem Handscanner
Die Zebra DS8208-R und DS8288-R scannen 1D/2D-Barcodes und lesen RFID-Tags. Wir zeigen Dir, welcher Handscanner zu Deinem Kassen- oder Lagerplatz passt und worauf Du bei der Auswahl achtest.
weiterlesen 19Okt
Zebra TC201 im Praxis-Check: Mobiler Computer für Lager, Handel und Field Service
Der Zebra TC201 bringt Wi-Fi 7, Bluetooth 6.0 und optional 5G in den mobilen Arbeitsalltag. Was der neue Handheld bei Warenannahme, Inventur und Kommissionierung leistet und worauf Du bei der Konfiguration achtest.
weiterlesen